Automatización de la gestión de solicitudes
Cómo dividir la gestión de solicitudes en etapas automatizables, dónde establecer el límite humano y qué medir para saber si ha ayudado.
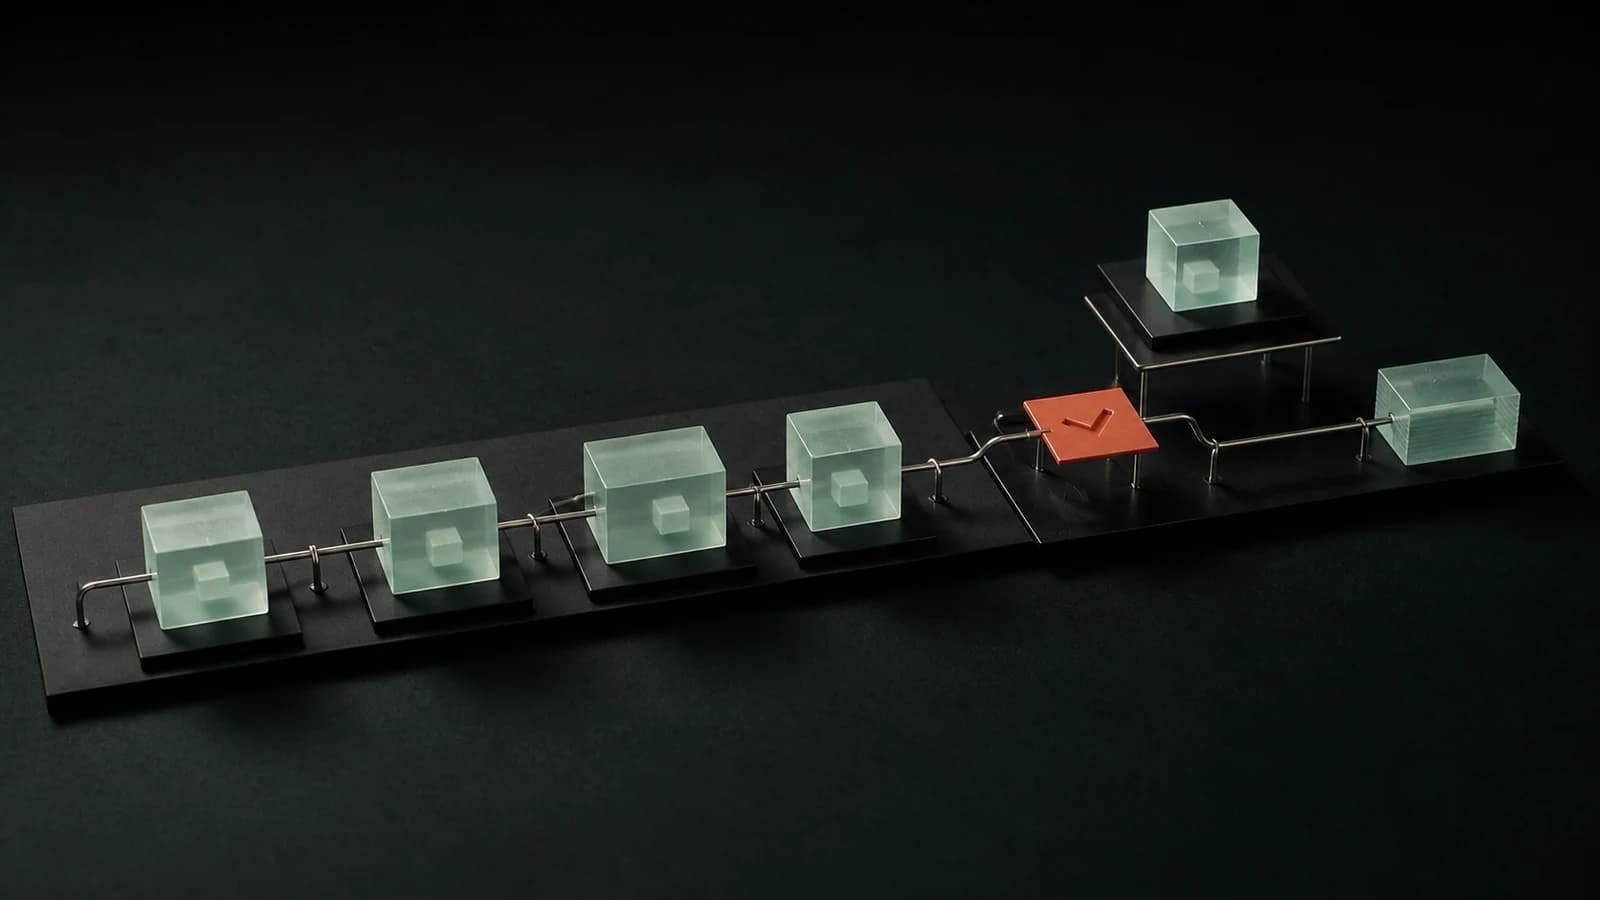
Conviene dividir la gestión de solicitudes en etapas y automatizar solo las decisiones que sean repetitivas, medibles y seguras. La recepción de un caso, el enriquecimiento con datos o la preparación de un borrador suelen ser buenos candidatos; el alcance de la clasificación y el envío automáticos dependen de la calidad de los datos y del coste del error.
La división por etapas permite evaluar por separado el beneficio, el riesgo y la protección necesaria. El objetivo «la IA responde correos» es demasiado amplio para construir una prueba o un criterio de aceptación.
Seis etapas de gestión de una solicitud
| Etapa | Qué sucede | Quién lo hace |
|---|---|---|
| 1. Recepción | la solicitud llega por correo, formulario, chat o teléfono | automatización |
| 2. Clasificación | se determina el tipo de caso, urgencia y equipo adecuado | automatización con capa de IA |
| 3. Enriquecimiento | se añaden datos del cliente, historial y estado del pedido | automatización |
| 4. Preparación de respuesta | borrador a partir de la base de conocimiento | capa de IA |
| 5. Resolución | decisión sobre un caso no estándar | persona |
| 6. Cierre y medición | cierre, evaluación y registro en la base de conocimiento | automatización |
Antes de generar respuestas, merece la pena medir las etapas 1–3. Establecer manualmente el contexto —quién escribe, de qué trata el caso y qué ocurrió antes— puede costar tanto como redactar el mensaje y suele ser más fácil de automatizar.
La etapa 2 en detalle: clasificación
La clasificación suele ser un buen primer paso cuando:
- es frecuente (cada solicitud);
- tiene un criterio de corrección claro (la categoría es correcta o no);
- el error es barato y reversible (el caso llega a la cola equivocada y vuelve);
- existe un conjunto representativo de solicitudes históricas para probar.
El modelo puede devolver una categoría y una puntuación que se use para decidir la escalada. Esa puntuación no es automáticamente una probabilidad calibrada de corrección. El umbral debe fijarse con datos históricos, por separado para las categorías importantes, y después controlarse al cambiar los datos o el modelo. Una puntuación baja, la ausencia de datos requeridos y las categorías de alto riesgo deben dirigir el caso a una persona.
La etapa 4 en detalle: borrador de respuesta
Si la respuesta debe referirse a reglas de una empresa concreta, su base debe estar escrita en una fuente controlada. Cuando el conocimiento permanece solo en las cabezas de quienes trabajan allí, el sistema no tiene material fiable para fundamentar una respuesta.
Por eso, en esta etapa el orden suele ser el contrario de lo esperado: primero ordenar la base de conocimiento (second brain), y después generar respuestas. Sin este paso aparece un sistema que responde con cortesía y sin verdad.
Tres niveles de riesgo que ayudan a elegir una secuencia segura de implantación:
- Sugerencia para el operador. El sistema propone una respuesta; una persona la corrige y la envía. Es el inicio más seguro y ya permite ver ahorro de tiempo.
- Envío automático en asuntos rutinarios. Solo en una categoría estrecha y elegida, con registro completo.
- Gestión completa de extremo a extremo para tipos de solicitudes seleccionados, con escalada a una persona ante desviaciones.
Pasar directamente al tercer nivel aumenta el coste del primer error porque el resultado llega de forma directa al cliente. Cada nivel debe tener su propia prueba de aceptación y posibilidad de revertir rápidamente el cambio.
Dónde establecer el límite humano
Una solicitud permanece con una persona si cumple cualquiera de estas condiciones:
- implica una decisión de alto coste o consecuencia legal, por ejemplo una devolución, reclamación o corrección no estándar;
- requiere empatía o desescalada: un clasificador de emociones puede ser una señal auxiliar, no la única base;
- el modelo no está seguro de la categoría o de la base de la respuesta;
- no hay base en la base de conocimiento: en ese caso la respuesta correcta del sistema es transferir el caso, no ser creativo;
- el cliente pide expresamente hablar con una persona.
El último punto es una cuestión de decencia y conviene tratarlo como un requisito, no como una opción.
Qué medir
Sin una medición anterior al cambio no sabrás si ha ayudado. Cuatro cifras que recoger antes y después:
- tiempo hasta la primera respuesta y tiempo hasta la resolución (mediana y peores casos, no media);
- porcentaje de solicitudes gestionadas sin intervención humana;
- porcentaje de casos que vuelven, porque aquí se ve reducir el tiempo contestando cualquier cosa;
- precisión de la clasificación.
El porcentaje de casos que regresan es una métrica de protección importante: el tiempo de gestión se puede mejorar fácilmente de una forma que empeore la calidad de respuesta. La elección del indicador principal depende del objetivo del proceso; evalúa el resultado temporal junto con calidad y coste de escalada. Más sobre cómo elegir indicadores: métricas de vanidad.
Cuándo no compensa
- Con pocas solicitudes. Calcula el coste anual del trabajo y los errores actuales; el volumen puede no justificar la construcción y el mantenimiento de la integración.
- Cuando cada caso es diferente. La automatización vive de la repetición. Si no hay dos solicitudes parecidas, solo queda enriquecer con datos.
- Cuando no existe base de conocimiento y nadie quiere crearla. Es una condición necesaria para la etapa 4.
- Cuando el problema es el número de solicitudes, no su gestión. Si los clientes preguntan lo mismo porque el sitio no responde esas preguntas, es más barato mejorar el sitio. Automatizar el efecto en lugar de la causa es un error clásico.
El umbral de rentabilidad depende del volumen, el tiempo de trabajo, el coste de errores y el coste de mantenimiento. Calcúlalo con tus propios datos antes de ampliar el piloto.
Cuánto cuesta
Nuestros rangos para agosto de 2026 son: una automatización individual (por ejemplo, recepción más clasificación más enriquecimiento), 2.000–8.000 PLN netos; un flujo de solicitudes más completo con capa de IA y borradores de respuesta, 8.000–25.000 PLN netos; un agente que gestione el caso de extremo a extremo, 8.000–30.000 PLN netos. Mantenimiento y ajuste: 1.500–5.000 PLN netos/mes.
Recomendamos empezar por una sola etapa: lo vendemos como primer proceso automatizado, porque la primera automatización debe ser una prueba económica de que funciona, no una gran inversión.
Preguntas frecuentes
¿Hay que cambiar el sistema de solicitudes que usamos?
A menudo no, si el sistema actual ofrece una API, eventos o una exportación segura adecuados. Primero comprobamos alcance de datos, límites, permisos y posibilidad de reproducir un error; si la integración no ofrece el control necesario, la recomendación puede incluir cambiar de herramienta o un alcance más estrecho. Consulta automatización de procesos.
¿El cliente notará que responde una automatización?
El diseño no debe basarse en ocultar la automatización. El artículo 50 de la Ley de IA de la UE exige, por regla general, informar a una persona de que interactúa directamente con un sistema de IA, salvo que ello resulte evidente para una persona razonablemente atenta e informada. La parte principal del reglamento se aplica desde el 2 de agosto de 2026; conviene evaluar jurídicamente la interfaz concreta y las excepciones. En cualquier caso, el cliente debe tener una vía sencilla hacia una persona. Fuente: Reglamento (UE) 2024/1689, arts. 50 y 113.
¿Qué ocurre cuando el sistema se equivoca?
Por eso hacen falta registros, escalada y modo de sugerencia. Dirigir un caso de forma errónea puede ser reversible, pero hay que medir su coste real; un mensaje erróneo enviado al cliente puede tener mayor consecuencia. Por ello limitamos el envío automático a categorías probadas y lo implantamos solo después de evaluar la calidad.
Construimos automatizaciones que entran en producción con supervisión, porque mantenemos recolectores diseñados como servicios continuos. Las alertas deben revelar interrupciones: no fingimos que la monitorización garantice una disponibilidad del cien por cien. Consulta automatización de procesos y agentes de IA, o descríbenos cómo gestionáis hoy las solicitudes.
Autor
Maciej Szukalski
Fundador de Condictor · arquitecto de sistemas · investigación y desarrollo
Diseña y desarrolla productos digitales desde 2014. Se especializa en arquitectura, investigación y aplicaciones con capas de automatización e inteligencia.
Conoce su experiencia y forma de trabajo¿Tienes un problema que resolver?
Veamos cuál es el mejor primer paso
Describe tu situación en unas frases. Volveremos con preguntas o una propuesta concreta para el siguiente paso.